
Informations de la fiche
Fiche d’annuaire HiCyou
- Site web répertorié
- research.google
- Publié dans l’annuaire
- 26 mars 2026
- Dernière mise à jour de la fiche
- 26 mars 2026
Informations incluses dans la fiche
- Présentation
- 5 fonctionnalités clés
- 5 cas d’usage
Cette page décrit la fiche d’annuaire HiCyou. Elle ne constitue pas une certification de sécurité, de propriété ou de qualité du produit.
Vérifiez le site externe avant de partager des informations sensibles ou d’effectuer un achat.

Qu'est-ce que TurboQuant
TurboQuant est un ensemble d'algorithmes de quantification avancés développés par Google qui permettent une compression extrême pour les grands modèles de langage et les moteurs de recherche vectorielle sans sacrifier la précision. Il combine des techniques comme PolarQuant et QJL pour optimiser l'utilisation de la mémoire, réduisant les coûts d'infrastructure et accélérant l'inférence IA pour des déploiements évolutifs.
Fonctionnalités clés
Cas d'utilisation
- Chercheurs en IA compressant de grands modèles de langage pour accélérer l'expérimentation et réduire la surcharge de calcul
- Entreprises déployant des LLM en production pour réduire les coûts d'infrastructure et améliorer la vitesse d'inférence
- Startups développant des moteurs de recherche sémantique pour gérer efficacement des données vectorielles à grande échelle avec des ressources limitées
- Fournisseurs de services cloud optimisant le stockage et la récupération pour les modèles d'IA afin d'améliorer leurs offres de services
- Développeurs créant des applications d'IA en temps réel nécessitant une faible latence et une utilisation réduite de la mémoire
Pourquoi les startups ont-elles besoin de cet outil ?
Les startups ont besoin de TurboQuant pour minimiser les dépenses de calcul et de mémoire, essentielles pour mettre à l'échelle les applications IA avec un budget limité. En permettant une compression efficace, il permet aux startups de déployer des modèles avancés comme les LLM et les systèmes de recherche sémantique sans coûts d'infrastructure prohibitifs, favorisant l'innovation et la compétitivité.
Questions fréquentes
Alternatives à TurboQuant
Autres outils dans Physical

AirPods 5
1.5x Active Noise Cancellation, AI Siri, Live Translation
Masung MS-ZK650-M6
Customizable Printer for Printing Aluminium Nameplates & Business Cards
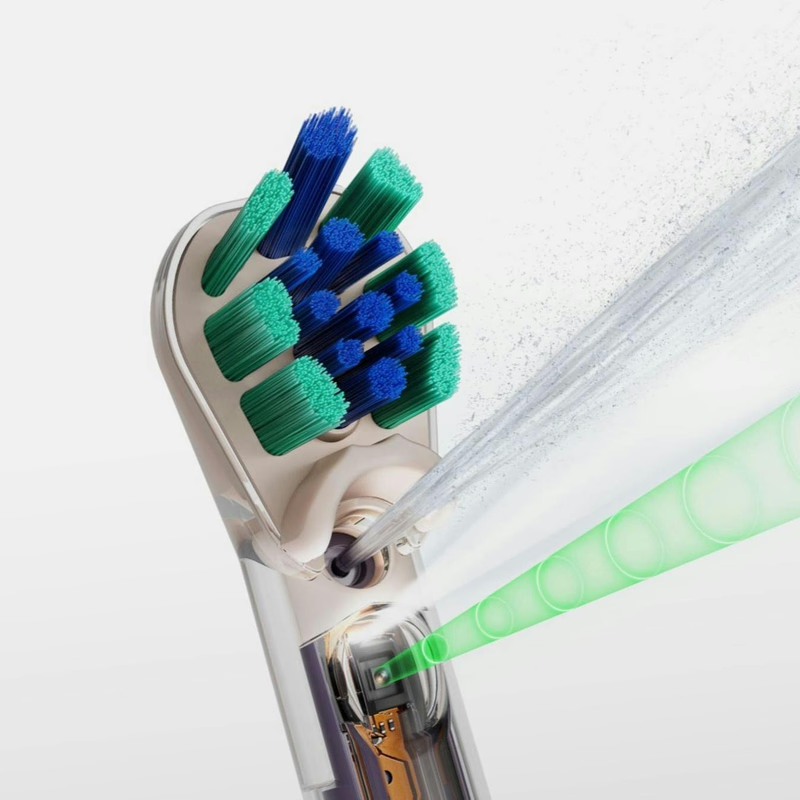
Dyson CameraJet
Precision-floss between teeth while you brush

CliQ For Home
Still using a programmable thermostat? CliQ is the $69 smart thermostat that upgrades your home in minutes